AI-teknologier til SOC-automatisering
I begyndelsen af 2000’erne begyndte vi at anvende algoritmer til maskinel indlæring til at opdage skadeligt software. Siden da har angriberne forbedret deres metoder. Nutidens målrettede angreb er kendetegnet ved høj diskretion – især ved meget begrænset anvendelse af malware, der kan opdages af antivirusprogrammer. I stedet benytter mange angribere sig af social engineering for at opnå indledende adgang og udnytter derefter fejlkonfigurationer i systemet samt legitim software til at bevæge sig lateralt og opretholde tilstedeværelsen i den kompromitterede infrastruktur.
For at opdage sådanne angreb er det nødvendigt at indsamle og analysere en stor mængde data om enheders, programmernes og brugernes adfærd i virksomhedens netværk. Og hver gang der opdages mistænkelig aktivitet, skal hændelsen verificeres for at fastslå, om der er tale om et angreb eller om en legitim aktivitet. I takt med at antallet af aktiver i en organisation vokser, stiger mængden af indsamlede telemetrioplysninger også, hvilket øger arbejdsbyrden for analytikerne i sikkerhedsoperationscentre og MDR-tjenester.
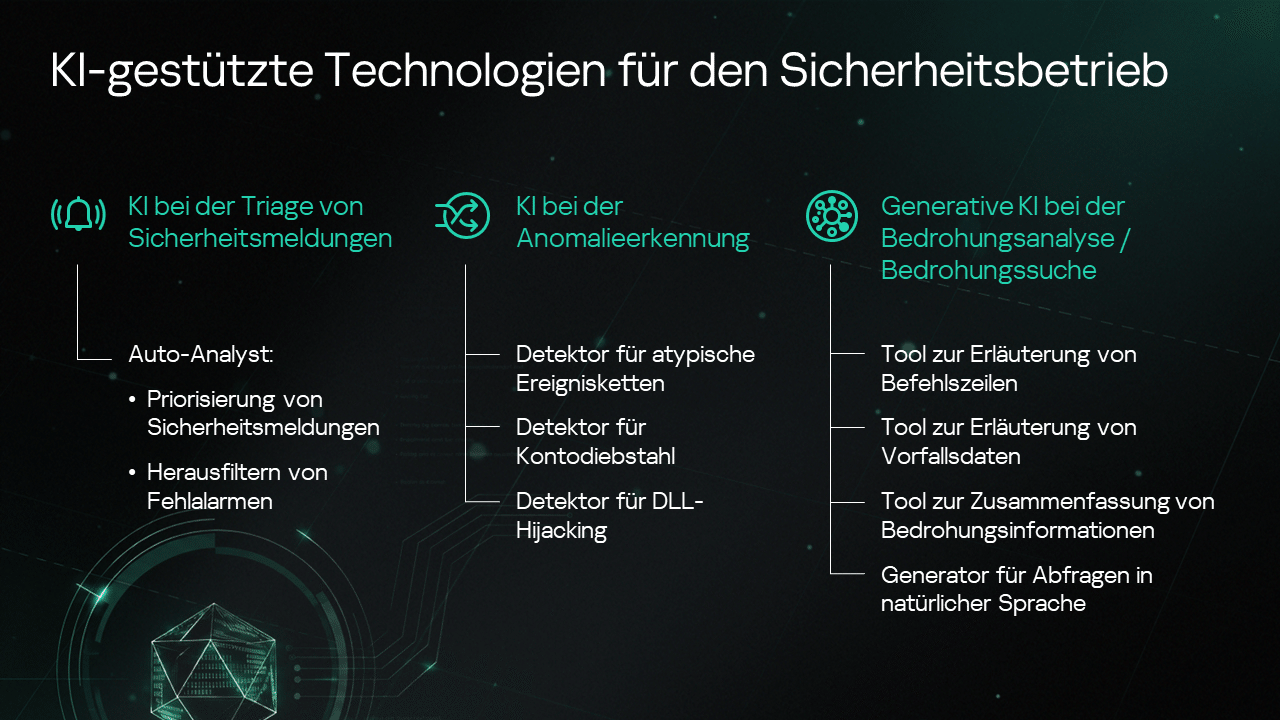
Automatisering baseret på AI-teknologier gør det muligt at forenkle dette arbejde betydeligt på flere områder:
- Triage: Prioritering af underretninger om mistænkelige hændelser i MDR/XDR/SIEM-telemetri og filtrering af falske positiver.
- Opdagelse af afvigende adfærd: Identifikation af tegn på kontotyveri, kompromittering af værtscomputere, DLL-kapringsangreb og andre skadelige aktiviteter.
- Datapræsentation: Sammenfatning og fortolkning af kommandolinjer, hændelser og TI-rapporter.
- Trusselsjagt i naturligt sprog: Omsætning af analytikernes hypoteser til SQL-forespørgsler.
Nedenfor beskriver vi, hvordan disse AI-teknologier implementeres i praksis i vores produkter og tjenester.
Automatisk analyse og prioritering af underretninger
Infrastrukturerne hos vores MDR-serviceklienter genererer dagligt milliarder af sikkerhedshændelser. Systemet til dataindsamling identificerer mistænkelige hændelser på baggrund af særlige regler for opdagelse og rapporterer denne potentielt skadelige aktivitet til analytikerne i form af underretninger: flere hundrede tusinde meddelelser om året. Dog vil kun omkring en tiendedel af disse underretninger vedrøre reelle sikkerhedshændelser.
Således står analytikere over for opgaven med at frasortere de "falske underretninger", som udgør størstedelen af advarslerne. Til dette formål udviklede vi et AI-system ved navn Auto-Analyst. Dette overvågede system med maskinel indlæring trænes på underretninger, der er markeret med SOC-analytikernes vurderinger. Målet er at kunne identificere falske positiver, der genereres af legitim netværksaktivitet, med stor sikkerhed.
Maskinel indlæring er her baseret på CatBoost – et populært gradient-boosting-bibliotek. Den trænede Auto-Analyst filtrerer underretninger og videresender kun dem til menneskelig gennemgang, der med en sandsynlighed over en specificeret grænse kan betragtes som en reel hændelse. Denne sandsynlighed bestemmes af den acceptable fejlrate. Dette medfører, at omkring 30 % af alarmerne håndteres udelukkende af AI'en, hvilket frigør tid for SOC-teamet til mere komplekse opgaver. De underretninger, der når frem til menneskelig analyse, er blevet prioriteret, så analytikerne kan fokusere på de mest kritiske først.
Flere detaljer om de praktiske aspekter af arbejdet som Auto-Analyst udfører (kontrol af træningsdata, selektiv gennemgang af resultater osv.) kan findes i en separat artikel, der er skrevet af vores eksperter.
Opdagelse af afvigelser i SIEM
Essensen af denne tilgang er at anvende telemetri, der er indsamlet, mens systemet fungerer "normalt", til at træne en AI-model, som derefter vil signalere afvigelser fra den normale adfærd.
Anvendelsen af sådanne algoritmer i store distribuerede systemer kompliceres af det enorme antal parametre, der skal tages højde for, når modellen bygges. Og sådanne modeller kan generere et stort antal falske positiver: I en organisation med tusindvis af brugere kan mange tilfælde af atypisk adfærd faktisk være legitime.
Denne tilgang kan dog med stor succes bruges til separate aktiver og processer, hvor det er muligt at opbygge en tilstrækkelig nøjagtig model for normal funktion.
Afvigende hændelseskæder
I dette tilfælde anvendes data om typiske sekvenser af udløsere for SIEM-korrelationsregler til at bygge en model for normal adfærd. Hyppige udløsere med samme sekvens er som regel falske positiver (f.eks. udførelse af automatiserede administrative scripts), og disse kan bruges som en indikator for typisk aktivitet i infrastrukturen.
Ved at bygge en profil over typisk værtsadfærd som et sæt sandsynligheder for, at bestemte regler udløses, kan vores AI-system vurdere, hvor typisk eller atypisk hver ny hændelseskæde er for den pågældende infrastruktur. Hvis der opdages en atypisk kæde, hæver systemet underretningens prioritet, hvilket henleder sikkerhedsspecialisternes opmærksomhed på sagen med henblik på en mere detaljeret analyse.
Kontotyveri
En anden teknologi til opdagelse af afvigelser gør det muligt at opdage potentielt uautoriseret aktivitet på brugerkonti. Her anvender ML-systemet par af enheder, såsom "konto-IP", "konto-vært", "konto-land" osv., til at oprette profiler over typisk kontoadfærd.
En angriber, der bruger en stjålet konto, vil som regel afvige fra det sædvanlige aktivitetsmønster. Angribere logger på systemet fra usædvanlige adresser og søger derefter efter måder at bevæge sig lateralt eller udvide deres rettigheder i systemet på, idet de besøger noder i infrastrukturen, som den legitime bruger af kontoen ikke ville have besøgt. AI-systemet opdager sådanne afvigelser og samler den nødvendige kontekst i en underretning, hvilket giver analytikerne mulighed for hurtigt at reagere på sådanne hændelser.
DLL-kapring
DLL-kapring er en angrebsmetode i operativsystemet Windows, hvor angribere erstatter et bibliotek, der kaldes af en legitim proces, med et skadeligt bibliotek. Det er ikke let at opdage sådanne angreb ved hjælp af traditionelle sikkerhedsløsninger, da det skadelige bibliotek kører inden for det betroede adresseområde, hvilket kan få sikkerhedsløsningen til at opfatte aktiviteten som en pålidelig proces. Det er ikke overraskende, at antallet af angreb, der benytter DLL-kapring, er steget markant i de seneste år.
For at udvikle en AI-model, der kan skelne mellem skadelige og legitime biblioteksindlæsninger, har vores eksperter identificeret en række kendetegn, der forekommer i mistænkelige tilfælde: forkert placering af biblioteket, forkert placering af den eksekverbare fil, omdøbt eksekverbar fil, ændringer i bibliotekets størrelse og struktur, manglende signatur osv. Til eksemplet til træning anvendte vi DLL-indlæsningsdata fra vores interne systemer til automatisk databehandling samt anonymiserede brugertelemetri fra KSN.
Yderligere oplysninger om træningsprocessen for denne model findes i en separat rapport. Allerede i pilotfasen har denne teknologi bidraget til at forhindre adskillige angreb på vores kunders systemer.
AI-assistenter baseret på generative modeller
Alle de foregående eksempler vedrører brugen af AI som klassifikator. Når modellen præsenteres for et nyt informationsobjekt, klassificerer den det som tilhørende en bestemt klasse ("det er en hund"). Sådanne ML-systemer trænes normalt på et begrænset udsnit af data, der er direkte relevante for opgaven.
Generativ AI fungerer "omvendt". Systemet modtager en bestemt type ønsket resultat som en forespørgsel ("tegn en hund for mig") og genererer nye informationsobjekter af den ønskede type. Til dette formål anvender systemet omfattende "viden" inden for fagområdet, som er opnået gennem forudgående træning af en stor sprogmodel (LLM) på enorme mængder offentligt tilgængelige data.
Dette gør det muligt at anvende LLM-baserede systemer til en bred vifte af opgaver, herunder arbejde med ustrukturerede data. Nutidens LLM’er er særligt gode til at håndtere tekstbehandlingsopgaver – såsom oversættelse, fortolkning og sammenfatning (dvs. at udarbejde en kortfattet version af den oprindelige tekst, samtidig med at de vigtigste idéer bevares).
For at løse lignende tekstbehandlingsopgaver i sikkerhedsprodukter og -tjenester har vi udviklet vores egen AI-assistentteknologi. Denne teknologi forbereder data til forespørgsler til LLM, udformer og sender forespørgsler, behandler resultaterne og videregiver dem til analytikere, samtidig med at den sikrer, at hele kommunikationen foregår sikkert.
AI-assistenten kan arbejde med enhver LLM, som kunden vælger, afhængigt af dennes opgaver og krav. For eksempel er cloudbaserede modeller som regel mere kraftfulde end dem, der er installeret i det lokale miljø, men ved at bruge modeller i det lokale miljø undgår man at overføre fortrolige data til tredjepartstjenester.
Fortolkning af kommandolinjer
En uklar kommandolinje er en almindelig type mistænkelig hændelse, der kræver nøje inspektion af en analytiker. Angribere bruger sådanne linjer til at give deres instruktioner direkte til den angrebne værts operativsystem, mens de undgår opdagelse. For at skjule skadelige kommandoer bruger de kodning, syntaksmanipulation og mange andre sløringsmetoder, hvilket gør det vanskeligt at identificere kommandoforfatterens sande hensigter.
Vores AI-assistent udfører først en statisk afkoding af den mistænkelige kommandolinje. Derefter sender den en række forespørgsler til LLM'en for at få en forklaring på alle kommandolinjeparametrene. Til sidst sender assistenten en sammenfatning til analytikeren: hvad linjen gør, og hvor farlig den er.
Opsummering af hændelsesdata
For at automatisere svar på hændelser vil nutidens SOC bruge funktionaliteten i Incident Response Platform (IRP). Dette program samler alle data relateret til en hændelse på ét kort, herunder relaterede sikkerhedshændelser og artefakter.
En sådan dataindsamling kan dog være meget omfattende, og det tager tid at analysere alle hændelsesoplysningerne manuelt. Derudover er der situationer, hvor analytikerne er nødt til at genkalde gamle hændelser – hvilket kræver, at man sætter brikkerne fra gamle puslespil sammen igen.
GenAI-assistenten forenkler dette arbejde betydeligt. Den indsamler al telemetri vedrørende hændelsen og udarbejder ved hjælp af LLM en kortfattet forklaring af, hvad der skete i sagen, herunder den oprindelige angrebsvektor og angriberens handlinger under hele hændelsen, samt anbefalinger til, hvordan man bør reagere.
Opsummering af trusselsintelligens (TI)
Når analytikere undersøger en hændelse, trækker de ofte på yderligere informationskilder om den pågældende trussel. En af disse kilder er vores Threat Intelligence Portal (TIP), som indeholder over fem petabyte trusselsinformation (TI), der er indsamlet af Kaspersky gennem mere end et kvart århundrede med opdagelse af trusler: hashværdier for skadelige filer, statistiske og adfærdsmæssige karakteristika, IP-adresser og URL’er til kommando- og kontrolcentre, hackergruppers TTP’er osv.
Et typisk scenarie for brugen af portalen ser således ud: En analytiker uploader en mistænkelig prøve, der er fundet under en hændelsesundersøgelse, og kører den i portalens sandkasse. Herefter modtager vedkommende detaljerede analyser: vurderinger og hashværdier for den opdagede malware, domæneadresser, som den har kontaktet, filer, der er hentet fra internettet, osv.
Alle disse data kan bruges som parametre til at søge efter yderligere TI fra åbne kilder. Portalen kan f.eks. vise rapporter om en APT-gruppe, der bruger de samme C2-adresser som dem, der blev opdaget, da prøven blev kørt i sandkassen. Dette giver analytikeren yderligere IoC’er, som vedkommende kan undersøge i sin infrastruktur.
Det kan dog tage meget tid at gennemgå en lang række forskellige TI-rapporter, især hvis de er skrevet på forskellige sprog og i forskellige formater. Vores AI-assistent udarbejder et struktureret resumé af TI-rapporterne, der viser, hvordan en given indikator hænger sammen med en bestemt gruppe, hvor og hvornår den var aktiv, hvilke teknikker den anvender osv. På samme måde kan AI-assistenten udarbejde en struktureret beskrivelse af en given APT-gruppe på baggrund af OSINT-data.
Trusselsjagt på naturligt sprog
Når en analytiker ønsker at indhente yderligere data om en igangværende hændelse eller proaktivt identificere en trussel på baggrund af nyligt modtagne indikatorer, skal vedkommende formulere en forespørgsel til et loglager eller en SIEM/EDR/XDR-database, hvor sikkerhedshændelser indsamles. Det kan imidlertid tage betydelig tid at omsætte analytikerens hypotese til SQL-forespørgsler med præcis syntaks og korrekte parametre, hvilket kan forsinke undersøgelses- og svarprocesserne.
Vores AI-assistent giver analytikere mulighed for at formulere forespørgsler til databasen på naturligt sprog, dvs. bogstaveligt talt på hypoteseniveau. Analytikeren kan f.eks. sige: "Vis alle hændelser, der fandt sted i går på den og den vært, hvor en eksekverbar fil med det og det navn var involveret." Når denne anmodning modtages, bruger AI-assistenten LLM til at udvælge de nødvendige felter fra datamodellen og sender derefter en SQL-forespørgsel til databasen. Inden den faktiske udførelse kan analytikere gennemgå den AI-genererede forespørgsel, validere logikken og justere parametre eller syntaks, hvis de ønsker det.


